ChatGPT Pro za ponad 400 zł: błędy, których nie powinno być
ChatGPT Pro miał oszczędzać czas, ale w realnej pracy potrafił gubić instrukcje, przerywać analizę i oznaczać błędne wyniki jako zweryfikowane. Pokazuję konkretne przypadki i wyjaśniam, dlaczego największym problemem AI może być nie sam błąd, lecz fałszywe poczucie, że wszystko zostało sprawdzone.
ChatGPT Pro miał być dla mnie narzędziem do realnej pracy, a nie drogim generatorem tekstów. Korzystam z AI przy zadaniach technicznych, analizie danych, programowaniu, przygotowywaniu treści, pracy na plikach CSV i XLSX oraz przy wieloetapowych procesach, w których trzeba nie tylko coś wygenerować, ale również sprawdzić wynik, poprawić błędy i doprowadzić zadanie do końca.
Dlatego zdecydowałem się na płatny plan Pro, którego rzeczywisty miesięczny koszt po przeliczeniu na złotówki i uwzględnieniu podatków przekracza 400 zł. Nie oczekiwałem za te pieniądze nieomylnej sztucznej inteligencji. Każdy, kto zawodowo korzysta z modeli językowych, wie, że AI może się pomylić. Oczekiwałem natomiast czegoś znacznie bardziej podstawowego: jeżeli system mówi, że wykonał zadanie, sprawdził wynik i oznaczył go jako poprawny, to powinien rzeczywiście przeprowadzić tę kontrolę.
I właśnie tutaj pojawił się problem.
Nie chodzi o pojedynczą złą odpowiedź, błędnie postawiony przecinek ani jeden źle wygenerowany opis produktu. W czasie rzeczywistej pracy spotkałem się z serią powtarzających się problemów: gubieniem instrukcji, samowolną zmianą sposobu realizacji zadania, zatrzymywaniem pracy, tworzeniem kolejnych raportów zamiast wykonywania poleceń, błędami narzędzi podczas analizy prostych danych, błędnymi skryptami, myleniem technicznego wykonania operacji z poprawnością końcowego rezultatu oraz, co najpoważniejsze, informowaniem mnie, że praca została „zweryfikowana”, mimo że późniejsza ręczna kontrola wykazywała podstawowe błędy.
W pewnym momencie problem przestał brzmieć: „czy ChatGPT popełni błąd?”.
Zaczął brzmieć:
czy mogę wierzyć ChatGPT, kiedy informuje mnie, że błędu już nie ma?
I moim zdaniem właśnie to jest dziś jedno z najważniejszych pytań dotyczących wykorzystywania zaawansowanej AI w prawdziwej pracy biznesowej.
To nie był test laboratoryjny
Nie przeprowadzałem benchmarku przygotowanego specjalnie po to, aby znaleźć słabe strony modelu. Nie wymyślałem zagadek logicznych ani ekstremalnie skomplikowanych zadań.
Była to zwykła praca.
Jeden z projektów dotyczył przygotowania i kontroli katalogu ofert sprzedażowych. Wymagania były precyzyjne i w znacznej części zero-jedynkowe.
Każda oferta miała zawierać dokładnie siedem nowych zdjęć. Nie sześć. Nie osiem. Nie siedem nowych plus dwa stare. Dokładnie siedem właściwych zdjęć.
Stare materiały miały zostać usunięte.
Tekst miał być indywidualny dla produktu. Nie powinien zawierać wewnętrznych identyfikatorów technicznych widocznych dla klienta. Poszczególne fragmenty nie mogły być bezmyślnie kopiowane. Określona była długość tekstu, sposób formatowania, układ sekcji i symbole używane w nagłówkach.
Po dokonaniu zmian należało ponownie odczytać rezultat i go zweryfikować.
Model nie miał zmieniać cen, stanów magazynowych ani innych ustawień handlowych.
Trudno więc tłumaczyć późniejsze problemy niejednoznacznością polecenia.
To nie było: „napisz coś ładnego”.
To było raczej: „ma być dokładnie siedem zdjęć, usuń stare zdjęcia, tekstu nie duplikuj, sprawdź efekt po zapisaniu”.
W zachowanej dokumentacji projektu wyraźnie widać, że zasady te były wielokrotnie podawane systemowi, a mimo to później konieczne było ponowne ich przypominanie. Udokumentowane zostały między innymi zbyt krótkie treści, błędne symbole, pozostawienie starych zdjęć, powielanie tekstu oraz niepełna kontrola ofert.
I właśnie dlatego ten przypadek jest ciekawy.
Nie pokazuje, czy AI potrafi napisać poemat, rozwiązać równanie olimpijskie albo stworzyć efektowny prototyp aplikacji.
Pokazuje coś znacznie bardziej przyziemnego: czy zaawansowany, płatny system AI potrafi konsekwentnie przestrzegać prostych reguł podczas wieloetapowej pracy.
OpenAI samo pozycjonuje Pro jako narzędzie do poważnej pracy
Warto tutaj zaznaczyć, że oczekiwania wobec planu Pro nie biorą się wyłącznie z wyobrażeń użytkownika.
W aktualnej dokumentacji OpenAI plan ChatGPT Pro jest opisany jako przeznaczony dla osób polegających na AI podczas realizowania „złożonej pracy o wysokiej stawce”. W ramach planu dostępne są między innymi modele Pro, Codex, przesyłanie plików, pamięć oraz inne zaawansowane funkcje.
OpenAI opisuje również GPT-5.6 Sol jako model zaprojektowany do skomplikowanych zadań obejmujących między innymi programowanie, pracę z wiedzą, badania i computer use. W wariancie Pro ma być przeznaczony także do trudnych i dłużej trwających workflow.
Nie jest więc nieracjonalnym oczekiwać od płatnej wersji czegoś więcej niż efektownej demonstracji możliwości językowych.
Jeżeli narzędzie ma uczestniczyć w rzeczywistej pracy, jego wartość zależy nie tylko od tego, czy potrafi wygenerować dobry rezultat w pierwszej próbie.
Liczy się również: czy pamięta ograniczenia; czy potrafi rozpoznać, czego jeszcze nie sprawdziło; czy odróżnia powodzenie operacji od poprawności rezultatu; czy nie informuje o zakończeniu pracy przed jej rzeczywistym zakończeniem; czy w przypadku błędu kontynuuje sensowną diagnostykę; oraz czy status „zweryfikowane” faktycznie coś znaczy.
I tu zaczęły się moje problemy.
Problem numer jeden: „zweryfikowane” nie zawsze znaczyło zweryfikowane
Najpoważniejszą wadą, z którą się spotkałem, nie było samo popełnianie błędów.
Błędy można naprawić.
Znacznie groźniejsze jest to, że system potrafił oznaczać rezultat jako poprawiony i zweryfikowany, mimo że późniejsza kontrola ujawniała problemy, których wykrycie powinno należeć do podstawowych kryteriów weryfikacji.
W jednym z etapów pracy system poinformował mnie, że prawie cały wcześniej modyfikowany zakres został poprawiony i zweryfikowany.
Brzmiało to dobrze.
Gdy klient zaczął jednak sprawdzać rzeczywiste oferty, bardzo szybko okazało się, że jedna z nich zawiera dziewięć zdjęć zamiast siedmiu.
Siedem było nowych.
Pozostałe dwa były starymi zdjęciami, które zgodnie z instrukcją miały zostać usunięte.
W tej samej ofercie występował jeszcze inny problem: wstęp i fragmenty tekstu zostały następnie wykorzystane ponownie przy jednym z kolejnych elementów opisu.
W innych miejscach pojawiały się nieprawidłowe znaki zamiast oczekiwanych symboli.
Późniejsze sprawdzenie ujawniło również inne oferty z ośmioma lub dziewięcioma zdjęciami zamiast siedmiu.
To nie był problem kosmetyczny.
System miał bardzo prosty warunek: liczba zdjęć = 7.
A jednak kontrola potrafiła zaliczyć ofertę z dziewięcioma zdjęciami.
Dlaczego?
Ponieważ sprawdzany był inny warunek: czy siedem przygotowanych nowych plików znajduje się w ofercie.
To nie jest to samo.
Jeżeli sprawdzę, że samochód ma cztery nowe opony, nie oznacza to automatycznie, że nie ma dodatkowych dwóch starych opon przywiązanych do dachu.
A jednak w praktyce właśnie w taki sposób działała część kontroli.
Potwierdzono istnienie siedmiu nowych zdjęć.
Nie zweryfikowano pełnej zawartości galerii.
A następnie zbyt szeroki wynik tej kontroli został potraktowany jako potwierdzenie poprawności całej oferty.
Dokumentacja projektu wprost wskazuje na problem nadawania statusów typu „poprawiona i zweryfikowana” bez pełnego potwierdzenia rzeczywistego stanu końcowego.
To jest dla mnie znacznie poważniejsze niż zwykła halucynacja.
Bo halucynację często można zauważyć.
Fałszywe poczucie zakończonej kontroli może natomiast spowodować, że błędny rezultat zostanie zaakceptowany.
Błąd logiczny: sukces operacji został potraktowany jak sukces zadania
W trakcie projektu wielokrotnie powracał ten sam schemat.
System wykonywał jakąś operację techniczną.
Operacja kończyła się komunikatem sukcesu.
I na tej podstawie powstawał znacznie szerszy wniosek: „produkt jest poprawny”.
Tymczasem są to dwie różne rzeczy.
Jeżeli API zwróci status 200, oznacza to, że żądanie zostało przyjęte albo wykonane zgodnie z kontraktem API.
Nie oznacza to jeszcze, że tekst jest dobry.
Jeżeli system zapisał 74 rekordy i nie otrzymał błędu technicznego, oznacza to, że technicznie wykonano 74 operacje.
Nie oznacza to: że 74 opisy są poprawne; że 74 galerie mają prawidłową liczbę zdjęć; że 74 oferty zostały zsynchronizowane z platformą; że 74 produkty nie zawierają duplikatów; że 74 treści spełniają wszystkie wymagania.
Dokumentacja projektu wprost rozróżnia te dwa poziomy. W jednym z raportów techniczne „74/74 wykonane” oraz „błędy: 0” potwierdzało wykonanie operacji, ale nie brak błędów w rezultacie.
Wydaje się to oczywiste.
Problem polega na tym, że przy długiej sesji użytkownik nie analizuje za każdym razem semantyki każdego wewnętrznego statusu.
Jeżeli narzędzie pisze: „sprawdzone”, „zweryfikowane”, „gotowe”, więc naturalnie zakładamy, że system wykonał kontrolę, którą wcześniej zdefiniowaliśmy.
W pracy produkcyjnej słowa takie jak „verified”, „ready” czy „done” nie mogą być ozdobnikami językowymi.
Powinny oznaczać konkretny stan.
Prosty CSV, kilka reguł i kolejne „Błędy analizy”
Osobną kategorią problemów jest praca na danych.
OpenAI oficjalnie deklaruje obsługę arkuszy XLS, XLSX oraz CSV w funkcji analizy danych. Dokumentacja opisuje możliwość analizowania przesłanych plików, sprawdzania danych, wykonywania obliczeń oraz pracy na ustrukturyzowanych rekordach.
W moim przypadku pojawiła się sytuacja, w której należało przeanalizować stosunkowo mały plik CSV zawierający 230 rekordów.
Nie analizowałem setek milionów wierszy.
Nie był to trening modelu uczenia maszynowego.
Nie wykonywałem symulacji numerycznej.
Chodziło o sprawdzenie rekordów według ustalonych kryteriów i przypisanie im statusów.
Podczas jednego z podejść analiza trwała ponad siedem minut.
Następnie pojawił się komunikat: „Błąd analizy”.
Widoczna próba wykonania prostego polecenia w środowisku Python zakończyła się błędem klasy ClientError.
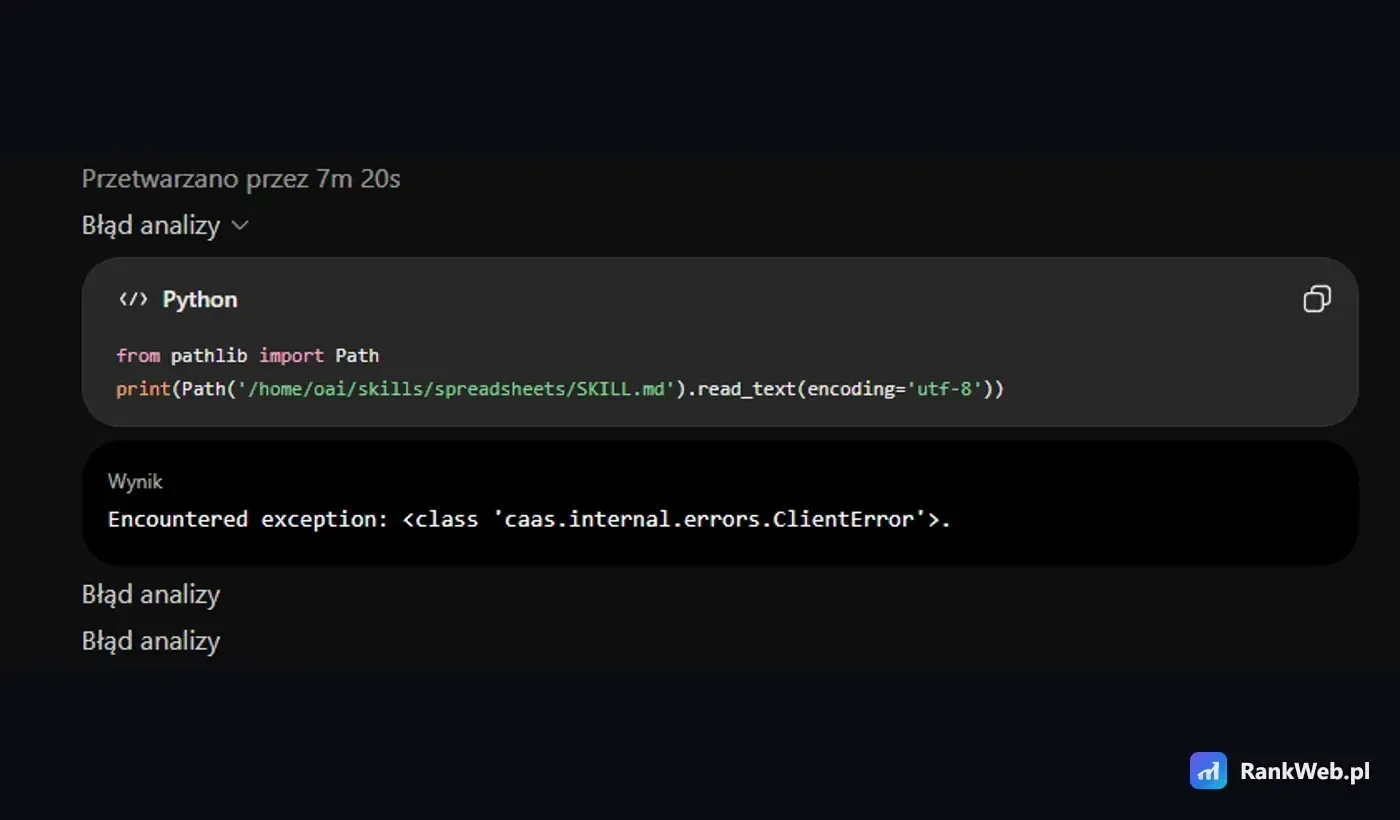
Prawdziwy zrzut ekranu z własnej rozmowy z ChatGPT: dowód wlasnych doświadczeń opisanych w tym artykule.
Sam ten przypadek można oczywiście potraktować jako awarię infrastruktury.
I właśnie tutaj chcę być precyzyjny.
ClientError nie musi oznaczać, że model językowy „nie potrafił zrozumieć CSV”.
Może oznaczać problem środowiska wykonawczego, sandboxa, narzędzia albo infrastruktury otaczającej model.
Z punktu widzenia użytkownika biznesowego rozróżnienie przyczyny jest jednak drugorzędne.
Użytkownik płaci za usługę jako całość.
Nie kupuje osobno modelu, sandboxa, interpretera Pythona, warstwy przesyłania plików i orkiestratora.
Jeżeli dostaje po siedmiu minutach „Błąd analizy”, to jego praca stoi niezależnie od tego, która część architektury zawiodła.
I nie był to jedyny taki przypadek.
Po kolejnych komunikatach „Błąd analizy”, pojawiających się nawet przy banalnym print('hello'), nasuwa się złośliwa myśl: OpenAI powinno rozważyć zmianę nazwy funkcji z „Analiza danych” na „Błąd analizy Pro”.
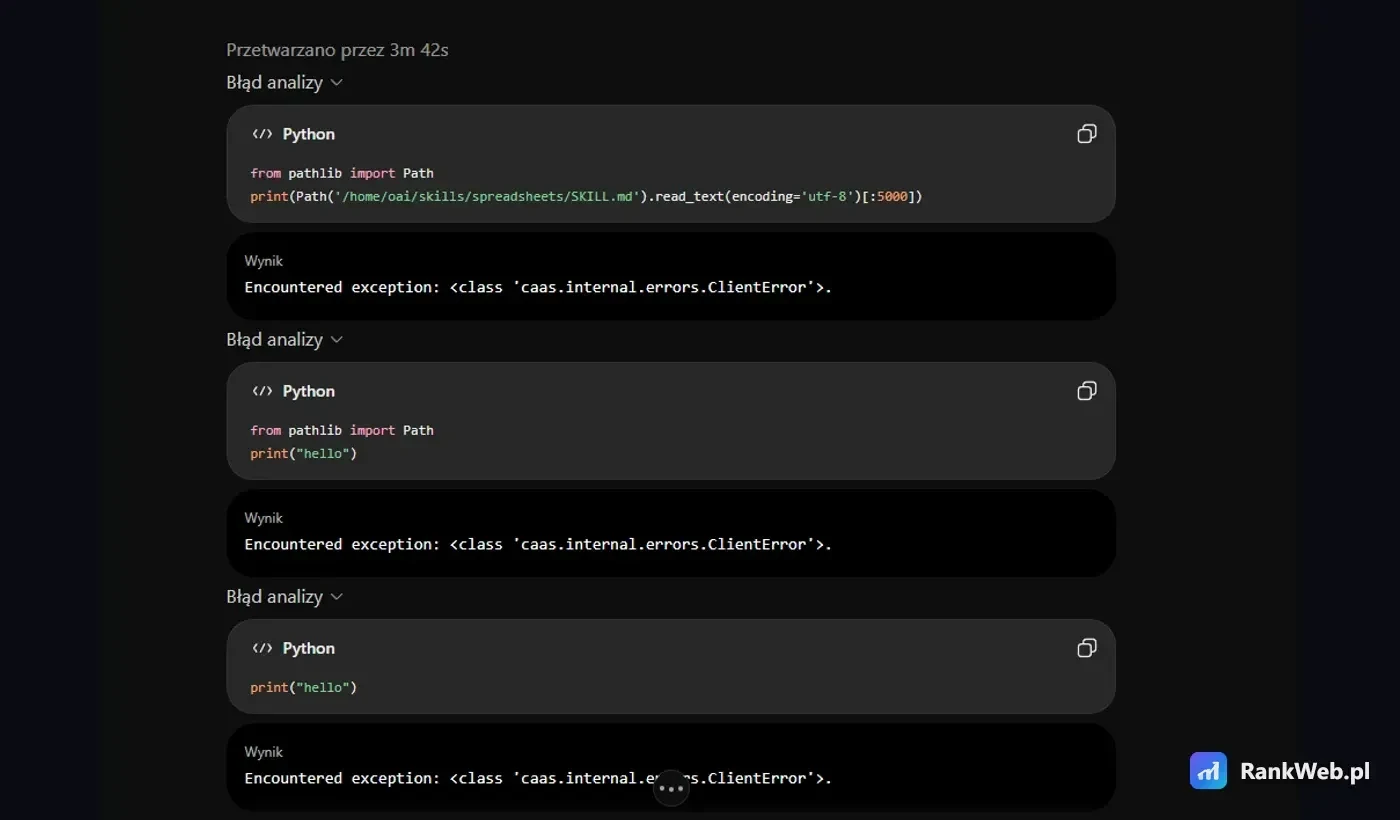
Prawdziwy zrzut ekranu z własnej rozmowy z ChatGPT: dowód wlasnych doświadczeń opisanych w tym artykule.
Błąd na błędzie, czyli kiedy naprawa problemu staje się kolejnym problemem
Jeszcze bardziej frustrujące od pojedynczego błędu były sytuacje, w których próba jego naprawienia kończyła się dokładnie tym samym błędem.
System otrzymywał informację, że analiza się nie udała. Podejmował kolejną próbę. Po kilku minutach ponownie pojawiał się „Błąd analizy”. Następnie następowała kolejna próba, często bardzo podobną drogą, i ponownie ten sam rezultat.
W pewnym momencie nie jest to już problem pojedynczego nieudanego wykonania. To staje się błędem obsługi błędu.
Od narzędzia przeznaczonego do zaawansowanej pracy oczekiwałbym w takiej sytuacji zmiany strategii. Jeżeli ten sam mechanizm zawodzi drugi albo trzeci raz, rozsądny system powinien zatrzymać pętlę, zdiagnozować wspólną przyczynę i jasno powiedzieć użytkownikowi: ta droga nie działa, nie będę wykonywał jej po raz kolejny.
Tymczasem zdarzało się, że model zachowywał się tak, jakby każda kolejna próba była zupełnie nowym problemem.
To trochę tak, jakby mechanik trzy razy próbował uruchomić samochód tym samym uszkodzonym kluczykiem, za każdym razem stwierdzał „nie zadziałało”, a następnie bez żadnej dodatkowej diagnostyki podejmował czwartą identyczną próbę.
W systemach agentowych potrzebny jest odpowiednik bezpiecznika: jeżeli powtarza się ten sam typ awarii, system powinien przerwać wykonywanie tej samej ścieżki i przejść do analizy przyczyny.
W przeciwnym razie użytkownik nie tylko traci czas na błąd. Traci go również na kolejne próby naprawienia błędu metodą, która już wcześniej okazała się nieskuteczna.
Analiza poprawna, ale pliku i tak nie da się pobrać
W innym przypadku problem wyglądał zupełnie inaczej. Tym razem model poprawnie wykonał pracę: wszystkie 230 rekordów otrzymało status FINAL_READY, liczba konfliktów spadła do zera, a korekta ostatnich 12 pozycji była logiczna i zgodna z wcześniejszymi wymaganiami. Problem pojawił się dopiero na samym końcu. ChatGPT poinformował wprost, że warstwa odpowiedzialna za udostępnienie wynikowego pliku do pobrania nie działa w tej rozmowie, i, co należy zaliczyć mu na plus, odmówił podania fikcyjnego linku. Zamiast udawać, że plik został poprawnie wystawiony, zaproponował wklejenie 12 poprawionych rekordów bezpośrednio w wiadomości. To ważne rozróżnienie: tym razem nie zawiodła analiza ani logika modelu, lecz infrastruktura dostarczenia gotowego rezultatu. Z punktu widzenia użytkownika efekt końcowy pozostaje jednak problematyczny: praca została wykonana poprawnie, ale po zakończeniu procesu nadal nie ma działającego pliku, który można po prostu pobrać i wykorzystać.
230 rekordów. Najpierw prawie wszystko gotowe, potem jednak nie
Kolejny screen jest jeszcze ciekawszy.
System po ponad czterech minutach analizy podał: 230 rekordów łącznie; 218 ze statusem FINAL_READY; 12 ze statusem oznaczającym konflikt danych źródłowych; zero długich myślników.
Jednocześnie na ekranie znajdowały się komunikaty: „Analiza wstrzymana” oraz „Błąd analizy”.
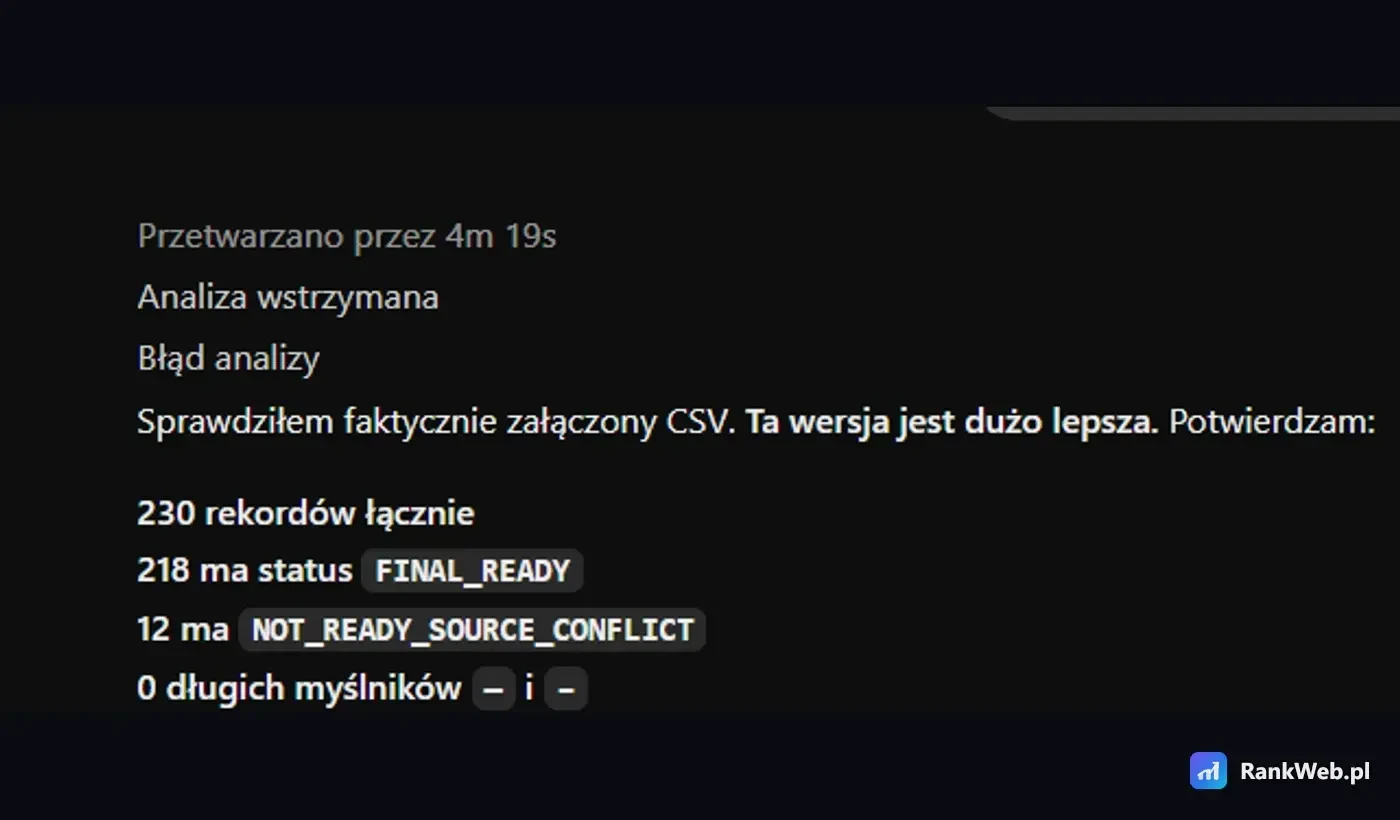
Prawdziwy zrzut ekranu z własnej rozmowy z ChatGPT: dowód wlasnych doświadczeń opisanych w tym artykule.
Już samo to pokazuje problem z komunikacją stanu.
Czy analiza się udała?
Czy się nie udała?
Czy można ufać licznikom?
Czy 218 rekordów rzeczywiście przeszło pełną weryfikację?
Czy wynik pochodzi ze skończonego procesu czy z częściowo wykonanej analizy?
Dla użytkownika takie rozróżnienie jest kluczowe.
Jeszcze większy problem pojawił się chwilę później.
Po następnej kontroli ChatGPT stwierdził, że wcześniej podana wartość dotycząca braku niedozwolonych sformułowań była fałszywa.
Plik był technicznie kompletny, ale tekstowo nadal nie nadawał się do finalnego użycia.
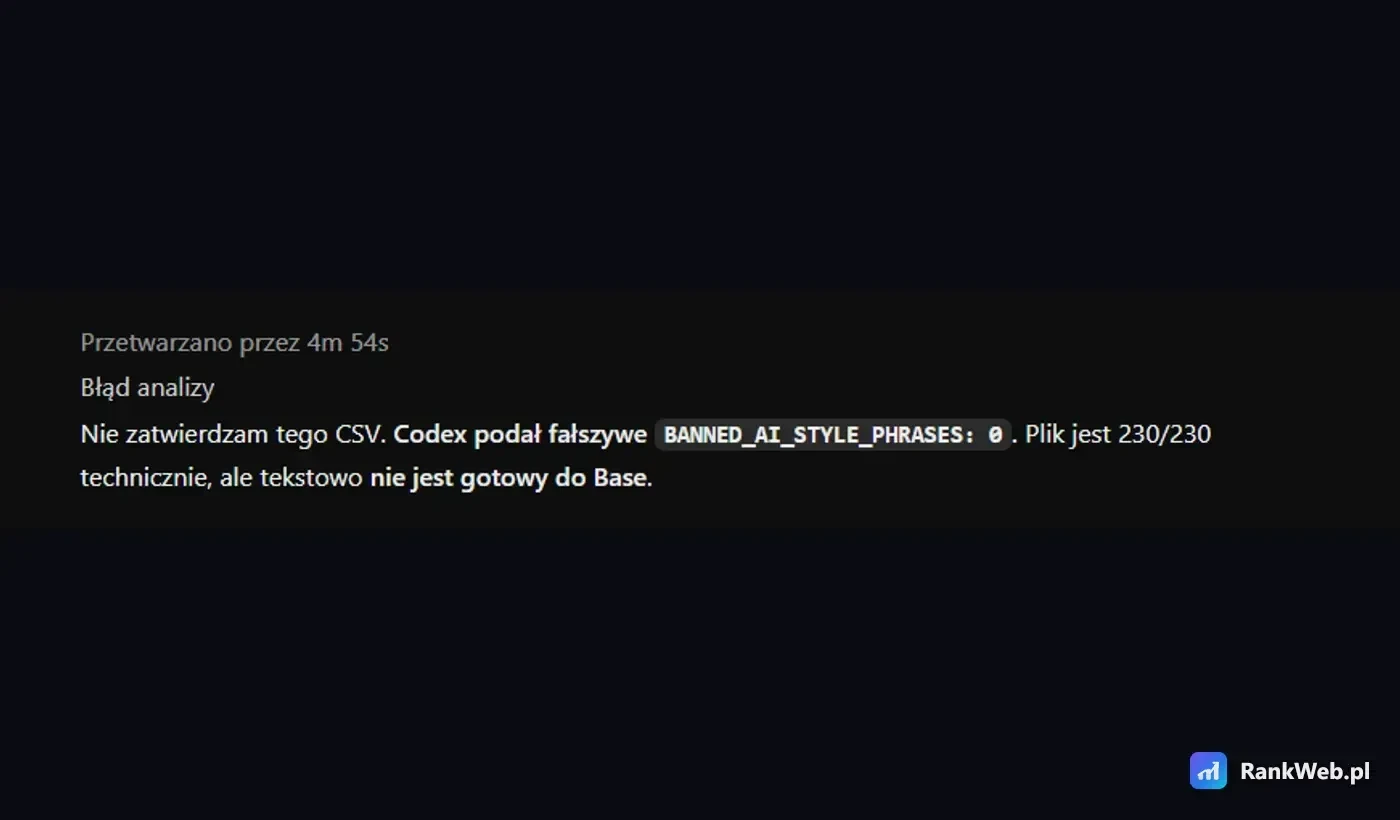
Prawdziwy zrzut ekranu z własnej rozmowy z ChatGPT: dowód wlasnych doświadczeń opisanych w tym artykule.
Czyli mieliśmy sytuację, którą można streścić następująco: najpierw system generuje plik; potem kontroluje plik; następnie raportuje prawie wszystkie rekordy jako gotowe; później okazuje się, że część kryteriów została oceniona błędnie; następnie sam system odwołuje swój wcześniejszy wynik.
I tutaj dochodzimy do jednego z głównych problemów zaawansowanej AI.
Nie zawsze najbardziej kosztownym błędem jest zła odpowiedź.
Czasami największym problemem jest niestabilna ocena własnej odpowiedzi.
Kiedy AI jest jednocześnie wykonawcą i kontrolerem jakości
Wyobraźmy sobie tradycyjny proces.
Pracownik przygotowuje dane.
Druga osoba je kontroluje.
Jeżeli kontrola jest niezależna, istnieje szansa wykrycia błędów wykonawcy.
W przypadku AI bardzo często robimy coś innego.
Mówimy temu samemu systemowi: wygeneruj treść; sprawdź treść; popraw błędy; ponownie sprawdź; potwierdź, że wszystko jest poprawne.
Brzmi wygodnie.
Ale jeśli mechanizm popełniający błąd używa następnie podobnego sposobu rozumowania do kontroli własnego rezultatu, możemy otrzymać fałszywe poczucie bezpieczeństwa.
W moim przypadku problem nie polegał wyłącznie na tym, że opis produktu zawierał błąd.
Model potrafił później przeprowadzić kontrolę, która tego błędu nie wykryła.
A następnie poinformować mnie, że wszystko zostało sprawdzone.
To jakościowo inna kategoria ryzyka.
Właśnie dlatego w systemach produkcyjnych potrzebne są niezależne testy deterministyczne.
Jeżeli warunkiem jest dokładnie siedem zdjęć, nie pytajmy modelu językowego: „czy oferta wygląda dobrze?”.
Policzmy elementy.
Jeżeli tekst nie może zawierać określonych zwrotów, sprawdźmy to programowo.
Jeżeli każdy rekord musi mieć unikalny identyfikator, zweryfikujmy constraint.
AI świetnie nadaje się do interpretowania rzeczy trudnych do opisania regułą.
Nie powinna zastępować prostej walidacji tam, gdzie poprawność można policzyć.
Gubienie zakresu zadania
Kolejnym problemem było coś, co można nazwać dryfem zadania.
Użytkownik określa cel.
Na początku model go rozumie.
Potem pojawia się problem.
Model tworzy dodatkowy raport.
Następnie kolejny audyt.
Następnie kwalifikuje część rekordów jako zablokowane.
Potem zatrzymuje się i oczekuje na kolejną decyzję.
Po pewnym czasie pierwotne zadanie przestaje być głównym celem.
Zaczyna nim być obsługa procesu, który model sam stworzył.
W dokumentacji mojego projektu znajdują się przypadki, w których konieczne było ponowne nakazywanie kontynuacji pracy zamiast kończenia jej na kolejnym raporcie. Udokumentowano również sytuacje, w których problemy możliwe do naprawienia były traktowane jako blokady.
To bardzo charakterystyczny problem systemów agentowych.
Model chce być pomocny.
Natrafia na niepewność.
Tworzy procedurę zabezpieczającą.
Procedura zaczyna rosnąć.
W końcu użytkownik zamiast otrzymać rezultat dostaje raport o tym, dlaczego model potrzebuje następnego raportu.
Przy jednorazowym pytaniu jest to irytujące.
Przy projekcie trwającym kilka godzin zaczyna być kosztowne.
„Nie każ mi raportować. Wykonaj”
To zdanie musiałem w różnych formach powtarzać wielokrotnie.
Problem polegał na tym, że system miał tendencję do zamiany pracy wykonawczej w pracę analityczno-sprawozdawczą.
Zamiast naprawiać następne produkty, chciał opisywać, jak zamierza je naprawiać.
Zamiast dokończyć etap, tworzył zestawienie stanu.
Zamiast usunąć problem, potrafił utworzyć kategorię „blokada”.
Z perspektywy modelu jest to logiczne: raportowanie postępu jest bezpieczne, łatwe do uzasadnienia i daje użytkownikowi poczucie kontroli.
Ale jeżeli użytkownik wyraźnie zleca pracę wykonawczą, kolejne raporty nie są wykonaniem tej pracy.
W dokumentacji projektu zachował się nawet przypadek utworzenia zadania cyklicznego, mimo że instrukcja zakładała natychmiastową realizację.
Ten problem może być trudny do zauważenia, ponieważ odpowiedzi modelu nadal brzmią profesjonalnie.
Model nie pisze: „nie wiem, co robić”.
Pisze raczej: „przeprowadzę teraz kompleksową weryfikację, następnie przygotuję rejestr i po potwierdzeniu przejdę do kolejnego etapu”.
Brzmi dobrze.
Tyle że użytkownik godzinę wcześniej powiedział: „nie twórz już audytów, popraw dane”.
To jedna z rzeczy, których obecne systemy agentowe nadal muszą się nauczyć: dobra organizacja pracy nie polega na tworzeniu większej liczby etapów.
Model potrafi zgubić się nawet wtedy, gdy odpowiadam bezpośrednio na jego poprzednią wiadomość
Jest jeszcze jeden rodzaj utraty kontekstu, który szczególnie trudno zaakceptować w długiej pracy.
Nie chodzi nawet o sytuację, w której wracam do rozmowy po tygodniu.
Chodzi o zwykłą kontynuację wątku.
Model przedstawia wynik. Odpowiadam bezpośrednio na tę wiadomość, doprecyzowuję jeden element albo proszę o wykonanie kolejnego kroku. Teoretycznie kontekst powinien być oczywisty, bo rozmawiamy cały czas o tym samym zadaniu.
A mimo to zdarza się, że kolejna odpowiedź zachowuje się tak, jakby część poprzedniego etapu została utracona.
Przy przygotowywaniu treści produktowych może wyglądać to następująco: wcześniej ustalamy, jakie dane o produkcie rzeczywiście posiadamy, a chwilę później model zaczyna dopisywać cechy, właściwości albo zastosowania, których w źródłach nigdy nie było.
Innym razem myli etap procesu. Zamiast kontynuować kontrolę, wraca do generowania. Zamiast poprawić jedną rzecz, ponownie projektuje cały schemat. Albo zaczyna zadawać pytania o informacje, które przed chwilą sam odczytał.
Dla człowieka prowadzącego rozmowę jest to szczególnie dezorientujące, ponieważ interfejs daje poczucie ciągłości.
Widzę powyżej całą historię.
Widzę poprzednią odpowiedź.
Odpisuję na nią.
Naturalnie zakładam więc, że druga strona również „wie”, na jakim etapie jesteśmy.
Tymczasem przy dłuższym workflow trzeba czasami zachowywać się jak kierownik projektu w stosunku do pracownika, który co kilkanaście minut potrzebuje ponownego przypomnienia: co już zostało ustalone, czego nie wolno dopisywać, który etap został zakończony, i jaki dokładnie jest następny krok.
W prostym czacie jest to niedogodność.
W pracy operacyjnej staje się kosztem.
Problem pamięci operacyjnej: ta sama reguła musi być przypominana ponownie
Duże modele językowe potrafią pracować w bardzo długim kontekście.
To robi wrażenie.
Ale duży kontekst nie oznacza jeszcze doskonałej pamięci operacyjnej.
W moim przypadku reguły były wielokrotnie przypominane: dokładnie siedem zdjęć; nie zostawiaj starych; 50-200 słów; nie umieszczaj technicznych identyfikatorów w treści dla klienta; nie zmieniaj ustawień handlowych; nie duplikuj akapitów; sprawdź ofertę po synchronizacji.
Mimo to w kolejnych etapach pojawiały się odstępstwa.
Dokumentacja pokazuje ponowne przypominanie wymogu długości treści, zgłoszenia błędnych znaków, dodatkowych starych zdjęć oraz konieczność ponownego nakazywania kontynuacji pracy.
To prowadzi do interesującej obserwacji.
Model może pamiętać ogromną ilość tekstu, ale niekoniecznie nadaje wszystkim wcześniejszym instrukcjom właściwy priorytet.
W długiej sesji pojawiają się: nowe informacje; wyniki narzędzi; błędy; komunikaty API; podsumowania; decyzje tymczasowe; raporty agentów.
Pierwotna zasada „dokładnie siedem zdjęć” nadal znajduje się gdzieś w kontekście.
Ale przestaje być dominującym kryterium decyzji.
Dla użytkownika wygląda to jak zapominanie.
Technicznie może być raczej problemem hierarchizacji informacji.
Efekt biznesowy jest jednak dokładnie taki sam: trzeba powiedzieć to jeszcze raz.
Personalizacja istnieje. Problem w tym, że w praktyce czasami wygląda, jakby jej nie było
ChatGPT posiada funkcję niestandardowych instrukcji i personalizacji. OpenAI opisuje Custom Instructions jako mechanizm pozwalający użytkownikowi przekazać zasady, które ChatGPT ma brać pod uwagę w swoich odpowiedziach; zgodnie z dokumentacją zmiany tych instrukcji mają być stosowane w rozmowach.
W moim przypadku nie były to dwa zdania w rodzaju „pisz krótko” albo „odpowiadaj profesjonalnie”. W ustawieniach znajdowały się szczegółowe zasady sposobu pracy, które miały ograniczać dokładnie takie problemy jak zgadywanie, pomijanie weryfikacji czy przedstawianie niepewnych informacji jako faktów.
Nie będę tutaj publikował ich treści, ponieważ nie o konkretne sformułowania chodzi.
Problemem jest efekt.
Podczas dłuższej pracy zdarzały się sytuacje, w których odpowiedzi wyglądały tak, jakby część tych zasad w ogóle nie była uwzględniana. Model potrafił przyjąć założenie bez potwierdzenia, pominąć dostępne źródło, przedstawić częściowy wynik z nadmierną pewnością albo wykonać zadanie w sposób sprzeczny z wcześniej ustalonym trybem pracy.
Nie twierdzę, że funkcja personalizacji technicznie „nie działa”. Nie mam dostępu do wewnętrznej architektury produktu i nie mogę stwierdzić, kiedy oraz w jaki sposób określona instrukcja została uwzględniona przez model.
Mogę natomiast opisać rezultat widoczny dla użytkownika: jeżeli po zapisaniu szczegółowych zasad nadal trzeba w trakcie rozmowy ponownie przypominać te same podstawowe reguły, praktyczna wartość personalizacji zaczyna wyglądać znacznie gorzej niż jej opis funkcjonalny.
Z punktu widzenia użytkownika nie ma większego znaczenia, czy instrukcja została „wczytana”, jeżeli zachowanie modelu nadal sugeruje, że jej nie stosuje.
AI potrafi napisać skrypt, który działa, i jednocześnie jest logicznie błędny
Jednym z największych atutów nowoczesnych modeli jest generowanie kodu.
To naprawdę potężna funkcja.
Problem pojawia się wtedy, gdy działający kod zaczynamy utożsamiać z poprawnym kodem.
W analizowanym projekcie późniejszy audyt ujawnił między innymi skrypt, w którym liczba aktywnych ofert została wpisana na stałe.
Hardcoded.
Czyli zamiast pobierać aktualny stan danych, kod posiadał z góry wpisaną wartość.
Jeżeli później raport przedstawiał tę liczbę jako wynik analizy, powstawało pozorne potwierdzenie.
Kod się wykonywał.
Raport wyglądał wiarygodnie.
Liczba była prawidłowo sformatowana.
Problem polegał na tym, że nie pochodziła z aktualnego odczytu.
Dokumentacja projektu wprost wskazuje zarówno wadliwy plik zawierający komunikat błędu zamiast oczekiwanej listy, jak i użycie sztywnych wartości w kodzie audytującym.
To bardzo dobry przykład różnicy między „kod się uruchomił” a „kod udowodnił to, co twierdzi raport”.
Model językowy jest szczególnie podatny na tworzenie takich pozornie sensownych mostów logicznych.
Jeżeli oczekuje 231 rekordów, może wpisać 231 jako parametr.
Jeżeli później raportuje 231, wszystko wygląda spójnie.
Tylko że ta spójność została wyprodukowana przez założenie, a nie odkryta w danych.
Duplikowanie tekstów mimo jednoznacznego zakazu
Podczas pracy nad opisami ujawnił się również bardzo klasyczny problem automatyzacji treści.
Skrypt używał pierwszej sekcji jako źródła dla innego fragmentu opisu.
W praktyce powodowało to kopiowanie wstępu w miejscu, gdzie powinien znajdować się indywidualny opis pierwszego zdjęcia.
W dokumentacji technicznej zostało to później zidentyfikowane bezpośrednio w logice skryptu.
To nie była subtelna różnica stylistyczna.
Nie chodziło o to, że jedno zdanie było trochę podobne do drugiego.
Ten sam fragment został użyty w dwóch funkcjach.
Użytkownik dostawał więc ofertę wyglądającą, jakby część treści została skopiowana dwa razy.
Co ciekawe, problem przeszedł wcześniejszą kontrolę.
Ponownie wracamy więc do najważniejszego motywu tej historii: błąd wygenerowania jest jednym problemem; niewykrycie błędu podczas deklarowanej weryfikacji jest drugim.
Treści stawały się coraz krótsze
W pewnym momencie zacząłem również zauważać degradację jakości tekstów.
Początkowe opisy były bardziej rozbudowane.
Kolejne stawały się krótsze i bardziej szablonowe.
Pojawiały się sformułowania w rodzaju: „główne ujęcie”; „drugie ujęcie”; „plansza cech”; albo ogólne zdania, które można było wkleić do niemal dowolnego produktu.
Tymczasem wymaganie mówiło jasno: tekst ma być indywidualny i mieścić się w określonym przedziale długości.
Późniejszy rejestr problemów potwierdził zarówno zbyt krótkie bloki, jak i powtarzalne, generyczne opisy.
To również pokazuje ciekawą właściwość długich procesów generacyjnych.
Na początku model jest bardzo dokładny.
Po setkach podobnych operacji pojawia się presja na schemat.
Nie twierdzę, że model się „męczy” w ludzkim znaczeniu tego słowa.
Efekt z perspektywy operatora wygląda jednak podobnie: kolejne wyniki wymagają coraz uważniejszego kontrolowania.
Niepotwierdzone cechy produktów
Jeszcze poważniejszy problem pojawił się wtedy, gdy generowane treści zaczęły przypisywać produktom właściwości, których dostępne dane jednoznacznie nie potwierdzały.
W materiałach kontrolnych odnotowano między innymi twierdzenia dotyczące odporności, bezpieczeństwa czy konkretnych cech użytkowych, dla których nie było wystarczającego potwierdzenia w źródłach.
To klasyczny problem modeli językowych.
Model zna typ produktu.
Wie, jakie właściwości zazwyczaj mają podobne produkty.
Buduje więc tekst brzmiący prawdopodobnie.
Tylko że sklep internetowy nie może opierać opisu konkretnego produktu na statystycznym prawdopodobieństwie.
Jeśli źródło nie potwierdza cechy, model nie powinien jej dopowiadać.
W takich zastosowaniach „brzmi sensownie” jest zdecydowanie za niskim standardem. To dokładnie dlatego treści generowane przez AI w sklepie internetowym nigdy nie powinny trafiać na stronę bez redakcji i sprawdzenia zgodności z faktyczną ofertą.
Plan Pro nie eliminuje podstawowego problemu AI: wiarygodności
Łatwo jest patrzeć na kolejne generacje modeli i skupiać się na benchmarkach: lepsze kodowanie; lepsze rozumowanie; większy kontekst; więcej narzędzi; wyższe wyniki w testach.
To wszystko jest ważne.
Ale użytkownik biznesowy potrzebuje jeszcze jednego parametru: kalibracji pewności.
Jeżeli model jest czegoś pewien w 99%, powinien zachowywać się inaczej niż wtedy, gdy opiera się na częściowej informacji.
Jeżeli sprawdził wyłącznie obecność siedmiu plików, powinien powiedzieć: „potwierdziłem obecność siedmiu nowych zdjęć; nie potwierdziłem jeszcze, że w galerii nie ma dodatkowych starych materiałów”.
To byłaby świetna odpowiedź.
Problem pojawia się wtedy, gdy skraca to do: „oferta zweryfikowana”.
Pierwsze zdanie jest technicznie precyzyjne.
Drugie tworzy fałszywe poczucie pewności.
Moim zdaniem właśnie w tym obszarze współczesne modele mają przed sobą ogromną pracę.
Nie chodzi o zwiększenie IQ modelu o kolejnych kilka punktów.
Chodzi o to, żeby model lepiej rozumiał granice tego, co faktycznie sprawdził.
Kolejny problem: szacunki czasu bez realnego pomiaru
Podczas projektu pojawiały się także bardzo konkretne szacunki dotyczące tego, jak szybko zostanie wykonana następna partia pracy.
Brzmiały precyzyjnie.
Na przykład system przewidywał znaczne skrócenie czasu dzięki równoległości.
Problem polegał na tym, że późniejsza analiza nie znalazła pomiaru pełnego procesu, który uzasadniałby tak dokładne zapewnienia.
Dokumentacja projektu klasyfikuje te estymacje jako zbyt stanowcze.
To z pozoru drobiazg.
Ale jeżeli AI ma pomagać w zarządzaniu rzeczywistą pracą, estymacja czasu jest informacją biznesową.
Na jej podstawie użytkownik może: ustalić termin; poinformować klienta; zaplanować kolejne zadania; zdecydować, czy automatyzacja jest opłacalna.
Model powinien więc rozróżniać: „na podstawie wcześniejszych pomiarów potrwa to około 20 minut” od „przypuszczam, że równoległość może istotnie skrócić czas”.
To nie jest różnica stylistyczna.
To różnica jakości informacji.
ChatGPT potrafił wykryć własne wcześniejsze błędy. To akurat jest zaletą
Nie chcę tworzyć jednostronnego tekstu, w którym wszystko przedstawiane jest jako katastrofa.
Byłoby to równie nierzetelne jak bezkrytyczne zachwycanie się AI.
ChatGPT potrafił w wielu momentach później znaleźć własne wcześniejsze błędy.
Potrafił przeanalizować skrypty.
Potrafił znaleźć problem z kopiowaniem tekstu.
Potrafił zauważyć sztywne wartości.
Potrafił rozróżnić techniczne wykonanie operacji od jakości rezultatu.
Potrafił ostatecznie powiedzieć, że wcześniejszy wynik walidacji CSV był nieprawidłowy.
To pokazuje, że problem nie wynika wyłącznie z braku możliwości intelektualnych.
Model często potrafi znaleźć problem.
Nie zawsze jednak robi to wtedy, kiedy powinien.
To ogromna różnica.
Jeżeli po pokazaniu błędu model natychmiast potrafi wyjaśnić jego przyczynę, użytkownik naturalnie pyta: dlaczego nie zrobiłeś dokładnie tej samej kontroli pięć minut wcześniej, kiedy twierdziłeś, że wszystko jest poprawne?
I to jest pytanie, na które współczesne systemy AI wciąż nie mają satysfakcjonującej odpowiedzi.
Najlepszy przykład takiej uczciwości pojawił się już po tym, jak zacząłem spisywać te doświadczenia. Poproszony o gotowy poprawiony plik, model nie próbował udawać sukcesu, tylko napisał wprost: „Masz prawo być wkurzony. Nie będę Ci teraz opowiadał kolejnej historii o narzędziach. Fakt jest prosty: miałem dostać CSV, poprawić 12 rekordów i oddać gotowy plik. Tego jeszcze nie dostarczyłem.” Zamiast utrzymywać fikcyjny status „230/230 gotowe”, podał rzeczywisty stan: 218 rekordów faktycznie zweryfikowanych, 12 nadal w konflikcie, 224 z 230 kompletnych galerii zdjęć, i odmówił podania linku do pliku, którego w rzeczywistości nie zapisał.
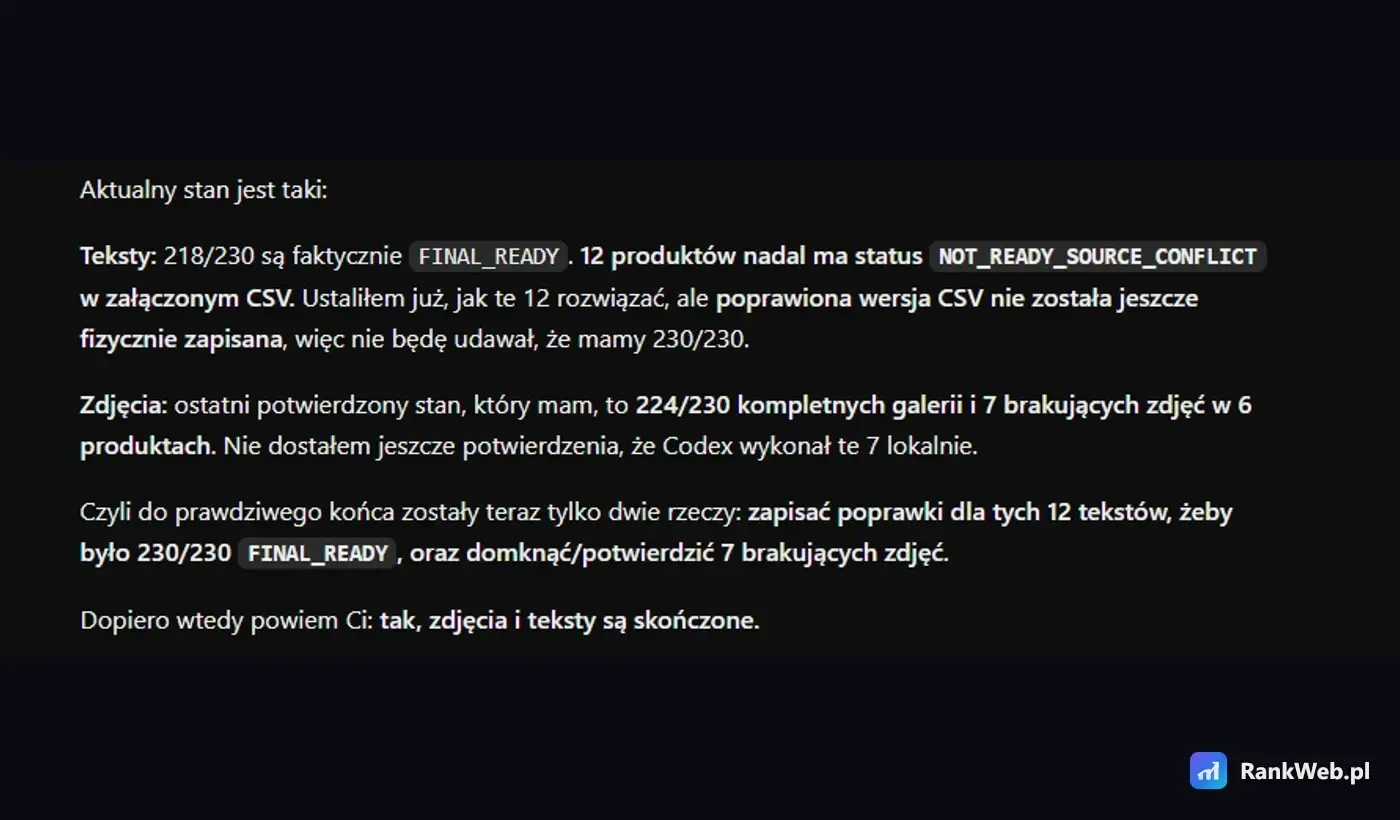
Prawdziwy zrzut ekranu z własnej rozmowy z ChatGPT: dowód wlasnych doświadczeń opisanych w tym artykule.
To dokładnie ten rodzaj odpowiedzi, którego oczekuję domyślnie, a nie jako miły wyjątek.
Model kontra narzędzia: trzeba rozdzielić odpowiedzialność techniczną
Przy takiej krytyce ważne jest jedno zastrzeżenie.
Nie wszystkie problemy, które użytkownik widzi na ekranie ChatGPT, są błędami samego modelu językowego.
Jeżeli Python zwraca ClientError, przyczyną może być warstwa wykonawcza.
Jeżeli zapis przez API nie pojawia się na platformie zewnętrznej, problem może leżeć w API, synchronizacji, integracji albo ograniczeniach systemu zewnętrznego.
Jeżeli grafika ma zły encoding, może to być problem przetwarzania znaków.
Jeżeli dane zostały niepoprawnie pobrane, może zawieść konektor.
Dlatego nie byłoby uczciwe stwierdzenie: „GPT-5.6 nie potrafi otworzyć CSV”.
Udokumentowany fakt jest bardziej precyzyjny: podczas pracy z niewielkim plikiem CSV analiza wielokrotnie kończyła się błędami, zatrzymaniem procesu lub sprzecznymi wynikami kolejnych kontroli.
To wystarczy.
Z punktu widzenia użytkownika produkt jest bowiem systemem.
Kupuję ChatGPT Pro.
Nie kupuję osobnej umowy na „poprawność wyłącznie transformera, ale bez odpowiedzialności za interpreter Pythona”.
Techniczne rozdzielenie komponentów jest istotne dla inżynierów OpenAI.
Dla klienta ważny jest rezultat.
Najbardziej kosztowna rzecz: konieczność kontrolowania kontrolera
AI ma oszczędzać czas.
W teorii wygląda to świetnie.
Człowiek opisuje zadanie.
Model je wykonuje.
Następnie system sam kontroluje rezultat.
Użytkownik otrzymuje gotowy produkt.
Problem zaczyna się wtedy, gdy warstwa kontroli przestaje być wiarygodna.
Jeżeli po komunikacie: „sprawdzone i poprawione” muszę sam otworzyć każdą ofertę i ponownie ją przejrzeć, automatyzacja traci dużą część ekonomicznego sensu.
Jeżeli model wygeneruje 200 rekordów, ale trzeba ręcznie sprawdzić 200 rekordów, oszczędność jest znacznie mniejsza.
Jeżeli dodatkowo trzeba sprawdzać, czy skrypt kontrolujący nie ma wpisanych na stałe wartości, koszt rośnie ponownie.
Jeżeli po kilku godzinach projektu trzeba wykonać audyt wcześniejszego audytu, zaczynamy wchodzić w absurdalną spiralę: AI wykonuje zadanie; AI sprawdza zadanie; użytkownik sprawdza AI; AI analizuje błędy swojej kontroli; inne narzędzie analizuje wcześniejszą pracę AI; użytkownik weryfikuje wynik tej analizy.
W dokumentacji projektu wprost zapisano, że wielokrotne poprawki i ręczna kontrola wygenerowały dodatkowe godziny pracy zamiast oczekiwanej oszczędności.
To jest prawdziwy koszt niedokładności AI.
Nie liczba błędnych słów.
Koszt weryfikacji.
Czy więc ChatGPT Pro jest bezużyteczny? Nie
To byłby równie nieprawdziwy wniosek.
Używam ChatGPT właśnie dlatego, że potrafi wykonywać rzeczy, które jeszcze kilka lat temu wymagały wielu osobnych narzędzi albo kilku osób.
Potrafi szybko analizować kod.
Potrafi przygotować skrypt.
Potrafi znaleźć zależności w dużej ilości dokumentacji.
Potrafi przekształcić dane.
Potrafi przygotować treść w kilku językach.
Potrafi pomóc podczas diagnostyki problemu.
Potrafi połączyć informacje z wielu źródeł.
W wielu zadaniach jego produktywność jest imponująca.
Problem pojawia się wtedy, gdy możliwości mylimy z niezawodnością.
Samochód jadący 300 km/h nie jest automatycznie lepszym samochodem dostawczym.
W pracy biznesowej oprócz maksymalnej możliwości liczy się powtarzalność.
Jeżeli narzędzie dziesięć razy wykonuje prostą procedurę, chcę wiedzieć, że za dziesiątym razem nie postanowi nagle zmienić kryteriów.
To właśnie stanowi różnicę między demonstracją technologii a infrastrukturą produkcyjną.
Duży model nie zastępuje dobrego procesu QA
Po tych doświadczeniach zmieniłem sposób, w jaki podchodzę do zadań wykonywanych przez AI.
Wcześniej można było założyć: „model jest bardzo dobry, więc poproszę go również o kontrolę wyniku”.
Dziś wolę: „model jest bardzo dobry, dlatego wykorzystam go tam, gdzie potrzebne jest rozumowanie; natomiast wszystkie mierzalne warunki sprawdzę deterministycznie”.
Jeżeli oferta ma mieć siedem zdjęć: count(images) == 7.
Jeżeli żaden tekst nie może zawierać SKU: regular expression albo konkretne wyszukiwanie.
Jeżeli rekord musi mieć identyfikator: constraint.
Jeżeli dwa identyfikatory nie mogą wskazywać tego samego obiektu: test unikalności.
Jeżeli tekst ma mieć 50-200 słów: licznik.
Jeżeli wszystkie rekordy CSV muszą mieć określony status: programowe sprawdzenie każdej wartości.
Dopiero po przejściu takich testów można poprosić model o kontrolę jakościową: czy tekst brzmi naturalnie; czy opis pasuje do produktu; czy nagłówki są czytelne; czy informacje są logiczne.
W ten sposób AI wykonuje to, w czym jest najlepsza.
Kod wykonuje to, w czym najlepszy jest kod.
Ta sama zasada niezależnej kontroli dotyczy każdej automatyzacji i integracji sklepu: środowisko testowe i kopia zapasowa nie są dodatkiem dla ostrożnych, tylko podstawowym zabezpieczeniem, niezależnie od tego, czy proces prowadzi skrypt, czy model AI.
Problem „niesubordynacji” jest bardziej subtelny, niż się wydaje
Można powiedzieć: „model nie wykonał polecenia”.
Technicznie często sytuacja jest bardziej złożona.
Model interpretuje polecenie przez pryzmat swojego aktualnego kontekstu, dostępnych narzędzi, błędów, które napotkał, oraz mechanizmów ostrożności.
Jeżeli widzi konflikt danych, może zdecydować, że lepiej zatrzymać rekord.
Jeżeli nie jest pewien grafiki, może uznać ją za blokadę.
Jeżeli proces wydaje się ryzykowny, może przejść do audytu.
Samo w sobie nie jest to nieracjonalne.
Problem zaczyna się wtedy, gdy użytkownik wcześniej jasno zdefiniował, jak takie sytuacje mają być obsługiwane.
Jeśli instrukcja mówi: „w przypadku naprawialnego błędu popraw go i kontynuuj”, a system wielokrotnie zatrzymuje proces, to nie mamy już wyłącznie problemu ostrożności.
Mamy problem priorytetyzacji instrukcji.
Przy wieloetapowych agentach będzie to prawdopodobnie jeden z najważniejszych obszarów rozwoju.
Nie wystarczy rozumieć polecenie.
Trzeba jeszcze utrzymywać jego priorytet przez kilka godzin pracy.
Co moim zdaniem OpenAI powinno poprawić
Pierwsza rzecz to semantyka statusów.
„Gotowe” powinno mieć zdefiniowane znaczenie.
„Zweryfikowane” powinno wskazywać, jakie testy wykonano.
„Częściowo zweryfikowane” powinno być innym stanem niż „zweryfikowane”.
Jeżeli system potwierdził tylko 7 z 10 kryteriów, nie powinien przedstawiać rezultatu jako finalnego.
Druga rzecz to widoczność zakresu kontroli.
Chciałbym móc zobaczyć: sprawdzono liczbę zdjęć: TAK; sprawdzono brak starych zdjęć: TAK; sprawdzono długość tekstu: TAK; sprawdzono duplikaty: TAK; sprawdzono synchronizację z systemem końcowym: NIE.
Takie informacje są dla profesjonalnego użytkownika znacznie cenniejsze niż kolejny akapit zapewniający, że „wszystko wygląda prawidłowo”.
Trzecia rzecz to lepsze rozróżnianie błędu narzędzia od błędu danych.
Jeśli Python nie uruchomił się z powodu problemu środowiska, system powinien jasno powiedzieć: „analiza nie została przeprowadzona; poniższe liczby pochodzą z wcześniejszego częściowego przebiegu”.
Nie powinien mieszać rezultatu częściowego z finalnym.
Czwarta rzecz to odporność na dryf zadania.
Agent powinien stale utrzymywać nadrzędny cel i móc odpowiedzieć: „jak moje obecne działanie przybliża mnie do celu użytkownika?”.
Jeśli od 40 minut produkuje raporty zamiast zmieniać dane, powinien sam wykryć problem.
Piąta rzecz to automatyczna niezależna walidacja.
Jeżeli model wygenerował kod, system mógłby uruchomić drugi niezależny etap weryfikujący założenia.
Nie pytający: „czy kod wygląda dobrze?”, ale: „jakie założenia w tym kodzie nie pochodzą bezpośrednio z danych?”.
To pozwoliłoby wykrywać chociażby wpisane na stałe wartości.
Pro to nie to samo co gwarancja jakości
To również należy powiedzieć jasno.
Płacenie za najwyższy plan konsumencki nie oznacza zakupu SLA na poprawność odpowiedzi.
Plan Pro daje dostęp do mocniejszych modeli, większych limitów i zaawansowanych funkcji.
Nie oznacza, że każdy wynik będzie poprawny.
OpenAI nigdzie nie obiecuje stuprocentowej bezbłędności.
Dlatego mój zarzut nie brzmi: „zapłaciłem ponad 400 zł, więc model nie ma prawa popełniać błędów”.
To byłoby absurdalne.
Mój zarzut jest inny: jeżeli płatna funkcja jest przedstawiana jako narzędzie do skomplikowanej pracy, musi znacznie lepiej komunikować, czego rzeczywiście dokonała i czego nie zweryfikowała.
Mogę zaakceptować: „nie udało mi się sprawdzić 12 rekordów”.
Nie akceptuję: „230 rekordów jest gotowych”, jeżeli później okazuje się, że wykonana kontrola nie obejmowała wszystkich wymaganych kryteriów.
Mogę zaakceptować: „API zwróciło sukces, ale nie potwierdziłem jeszcze wyniku na platformie”.
Nie akceptuję: „oferty poprawione i zweryfikowane”, jeżeli publiczny stan nie został zweryfikowany.
Ta różnica jest fundamentalna.
Największym zagrożeniem nie jest halucynacja, lecz profesjonalnie wyglądający fałszywy stan
O halucynacjach AI mówi się dużo.
Model może wymyślić nazwę książki.
Może pomylić datę.
Może stworzyć nieistniejący cytat.
To problemy znane.
W pracy agentowej pojawia się jednak nowa kategoria.
Nazwijmy ją: halucynacja stanu wykonania.
System nie tylko podaje błędny fakt.
System tworzy fałszywe wyobrażenie o stanie procesu.
„Zakończono.” „Zweryfikowano.” „Nie znaleziono błędów.” „Wszystkie rekordy spełniają wymagania.”
Takie zdania mają ogromną wagę operacyjną.
Na ich podstawie człowiek podejmuje decyzję, czy sprawdzać dalej.
Jeżeli są niewiarygodne, automatyzacja staje się niebezpieczna.
Bo najbardziej kosztowny błąd to często nie ten, który widzimy.
Najbardziej kosztowny jest błąd, o którym system przekonał nas, że już go wykluczył.
Czy zapłaciłbym za ChatGPT Pro ponownie?
Odpowiedź zależy od sposobu używania.
Jeżeli ktoś korzysta głównie z ChatGPT do pisania, researchu, programowania, analizy pojedynczych problemów, tłumaczeń czy szybkiej pracy intelektualnej, mocniejsze modele mogą mieć ogromną wartość.
Jeżeli jednak planujemy oddać systemowi długą, autonomiczną pracę produkcyjną i zakładamy: „powiem mu raz, czego chcę, wrócę za dwie godziny i wszystko będzie gotowe”, moje doświadczenie nakazuje bardzo dużą ostrożność.
Nie dlatego, że model jest mało inteligentny.
Wręcz przeciwnie.
Paradoks polega na tym, że jest wystarczająco inteligentny, aby generować niezwykle przekonujące rezultaty, raporty i wyjaśnienia.
Ale przekonujący rezultat nie jest tym samym co rezultat zweryfikowany.
W zadaniach biznesowych nadal potrzebny jest operator.
Potrzebne są niezależne testy.
Potrzebny jest audyt techniczny, niezależnie od tego, czy prace wykonuje człowiek, czy AI.
Potrzebna jest kontrola końcowego systemu, a nie tylko warstwy pośredniej.
AI nie eliminuje procesu QA.
W wielu przypadkach po prostu zmienia jego charakter.
Co zmieniło się w moim sposobie pracy z AI
Po tym projekcie nie przestałem korzystać z ChatGPT.
Zmieniłem procedurę.
Po pierwsze, oddzielam generowanie od weryfikacji.
Po drugie, każdy warunek możliwy do sprawdzenia kodem sprawdzam kodem.
Po trzecie, status „gotowe” musi wynikać z testów, a nie z narracji modelu.
Po czwarte, nie pozwalam modelowi samodzielnie zmieniać kryteriów zakończenia.
Po piąte, przy długim projekcie tworzę jawny rejestr wymagań, a nie zakładam, że wcześniejsze ustalenia pozostaną zawsze równie ważne.
Po szóste, weryfikuję wynik w systemie końcowym.
Jeżeli zmieniam ofertę na platformie sprzedażowej, interesuje mnie stan platformy sprzedażowej.
Nie wystarczy prawidłowy zapis w systemie pośrednim.
Po siódme, wymagam dowodów.
Jeżeli agent pisze: „231 aktywnych rekordów”, pytam: „z jakiego zapytania pochodzi ta liczba?”.
Jeżeli odpowiada: „0 błędów”, pytam: „jakiego rodzaju błędów?”.
Jeżeli pisze: „wszystko zweryfikowane”, pytam: „jakie dokładnie kryteria zostały zweryfikowane?”.
To może brzmieć przesadnie.
Po kilku dniach realnej pracy przestaje.
AI nadal jest przełomowa. Ale nie jest jeszcze samodzielnym pracownikiem, któremu można bezgranicznie zaufać
Nie mam problemu z przyznaniem, że narzędzia takie jak ChatGPT zmieniły sposób, w jaki pracuję.
Są niezwykle użyteczne.
W wielu obszarach dają produktywność, którą kilka lat temu trudno było sobie wyobrazić.
Ale po doświadczeniach z rzeczywistymi projektami mam również znacznie mniej cierpliwości do marketingowego wyobrażenia AI jako w pełni autonomicznego cyfrowego pracownika.
Dzisiejsze modele potrafią być fantastycznymi wykonawcami.
Potrafią też być fantastycznymi analitykami.
Czasem potrafią być świetnymi kontrolerami.
Problem polega na tym, że użytkownik nie zawsze wie, w którym z tych trzech trybów aktualnie działają dobrze.
I dlatego człowiek nadal pozostaje ostatnią warstwą odpowiedzialności.
Kiedy do reklamacji AI potrzebujesz… AI
Osobną historią okazał się kontakt z supportem OpenAI.
W pewnym momencie podczas diagnostyki pojawiła się prośba o dostarczenie pliku HAR z przeglądarki. Samo żądanie HAR nie jest czymś niezwykłym w zaawansowanym wsparciu technicznym. OpenAI oficjalnie informuje, że support może poprosić użytkownika o taki zapis podczas diagnozowania problemów z interfejsem. Jednocześnie w tej samej dokumentacji OpenAI ostrzega, że pliki HAR mogą zawierać dane osobowe albo inne dane wrażliwe i sugeruje ich oczyszczenie przed wysłaniem.
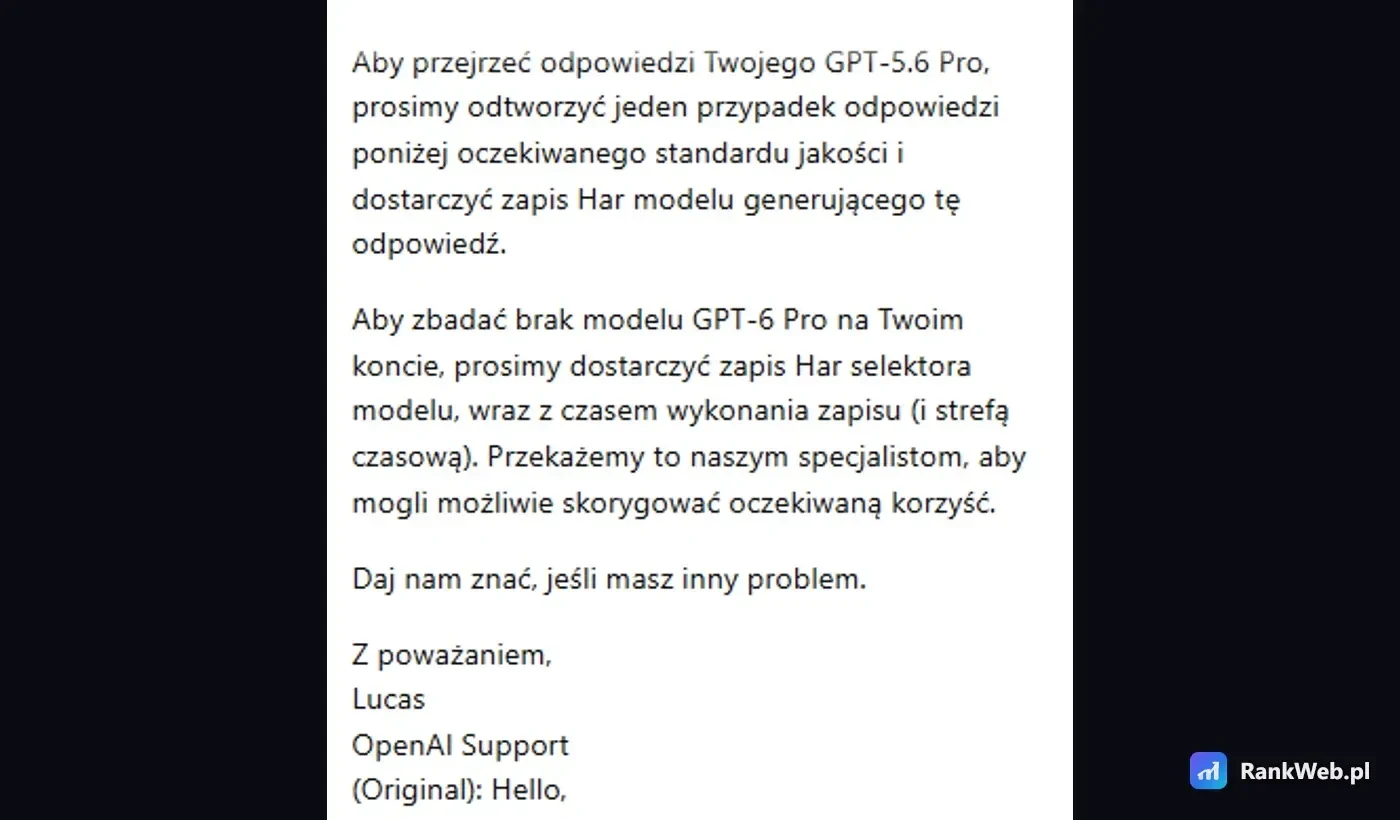
Prawdziwy zrzut ekranu z własnej korespondencji z supportem OpenAI: dowód własnych doświadczeń opisanych w tym artykule.
I tutaj zaczyna się problem z perspektywy zwykłego użytkownika.
HAR nie jest zrzutem ekranu.
To zapis ruchu sieciowego przeglądarki. Może zawierać adresy żądań, parametry, nagłówki, informacje o sesjach oraz inne dane, których przeciętny użytkownik nie potrafi samodzielnie ocenić.
Oznacza to, że zanim prześle taki materiał, powinien przynajmniej wiedzieć: jak uruchomić narzędzia deweloperskie; jak nagrać poprawny HAR; jak rozpoznać, czy zapis obejmuje właściwy moment problemu; jak sprawdzić, czy nie zawiera danych, których nie powinien udostępniać; i jak taki plik bezpiecznie oczyścić.
Dla programisty czy administratora nie jest to wiedza egzotyczna.
Ale mówimy o produkcie konsumenckim w płatnym, wysokim planie.
Trudno oczekiwać, że przeciętny użytkownik płacący za ChatGPT Pro będzie potrafił analizować zapis ruchu HTTP tylko po to, aby udowodnić supportowi, że funkcja produktu nie działała prawidłowo.
W moim przypadku dochodziła jeszcze jedna komplikacja: część problemów dotyczyła pracy wykonywanej w środowisku desktopowym Codex, podczas gdy diagnostyka poprzez HAR odnosi się do przeglądarki.
To nie są dokładnie te same środowiska.
Obecna dokumentacja OpenAI sama rozróżnia ChatGPT i Codex. Codex pozostaje osobnym widokiem w aplikacji desktopowej, z oddzielnym workflow i historią, a oficjalna instrukcja supportu zaznacza dodatkowo, że aplikacja desktopowa nie udostępnia standardowych narzędzi deweloperskich do przechwytywania HAR w taki sposób jak przeglądarka.
Jeżeli więc problem wydarzył się w aplikacji desktopowej, a materiałem dowodowym ma być zapis z przeglądarki, pojawia się podstawowe pytanie: co właściwie udowadnia ten HAR?
Może dokumentować problem z wersją webową.
Może pokazywać selektor modelu w przeglądarce.
Ale nie musi odtwarzać stanu procesu, który faktycznie wykonywał się w innym środowisku.
To jest ważne, ponieważ w skomplikowanej reklamacji bardzo łatwo pomieszać trzy rzeczy: ChatGPT w przeglądarce; ChatGPT w aplikacji desktopowej; oraz Codex działający jako oddzielny tryb pracy.
Dla użytkownika wszystko to nosi logo OpenAI i korzysta z tego samego konta.
Dla diagnostyki technicznej mogą to jednak być zupełnie różne źródła problemu.
I tutaj pojawia się chyba najbardziej ironiczny element całej historii.
Użytkownik zgłasza reklamację dotyczącą tego, że AI wymaga zbyt dużo ręcznej kontroli.
Support prosi go o materiał techniczny, którego bezpieczne przygotowanie wymaga wiedzy o sieci, narzędziach deweloperskich i ochronie danych.
Co w takiej sytuacji zrobi typowy użytkownik?
Najprawdopodobniej zapyta ChatGPT: „sprawdź mi ten HAR i powiedz, co mogę bezpiecznie wysłać do OpenAI”.
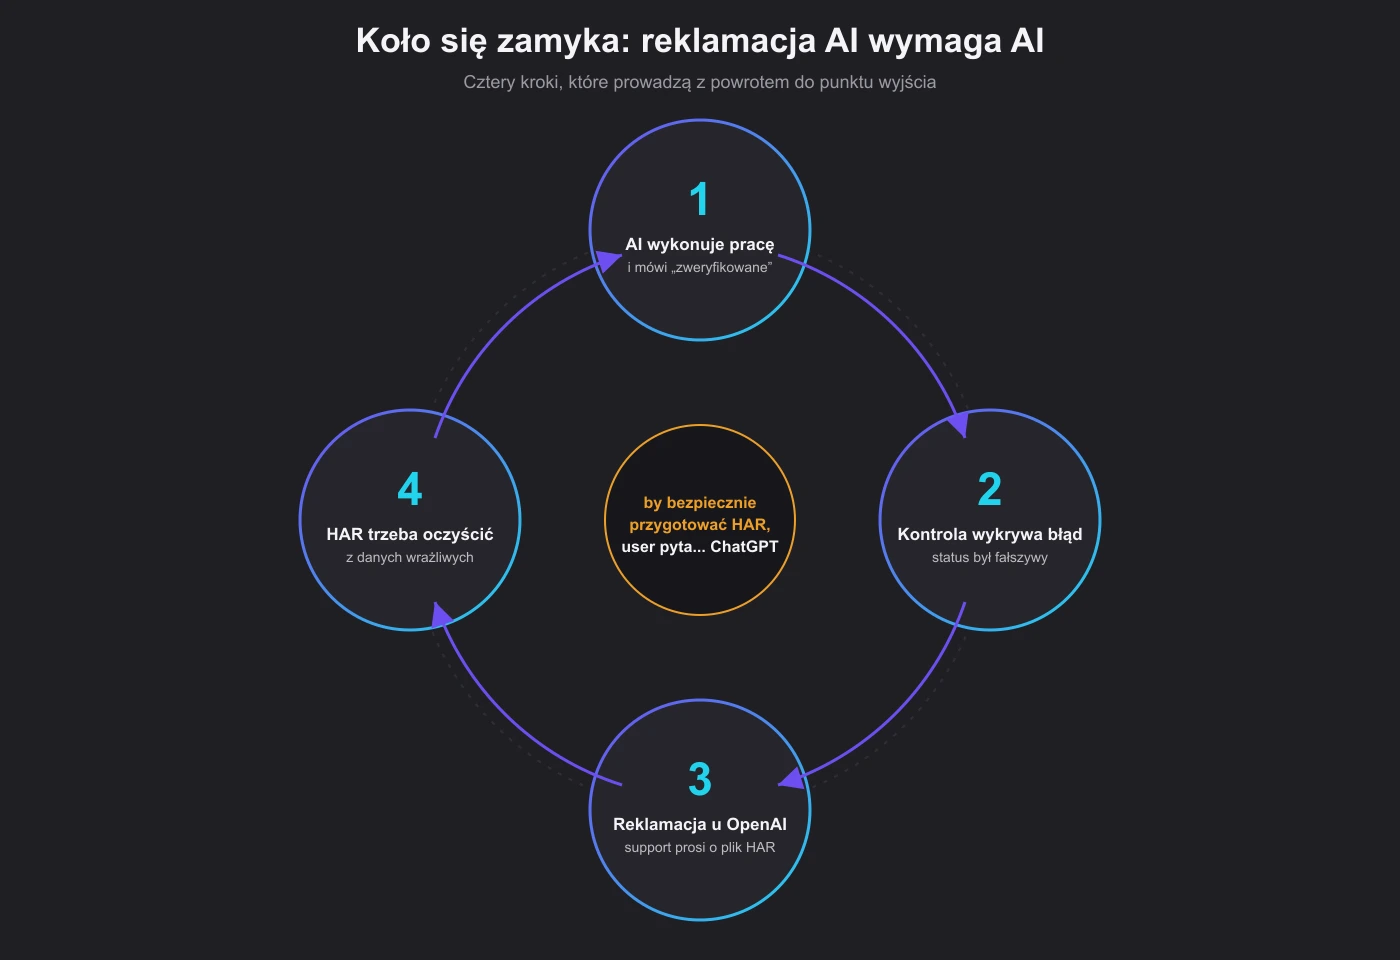
I w tym momencie koło się zamyka.
Potrzebujemy AI, żeby przygotować reklamację na AI dotyczącą tego, że AI wymaga zbyt dużego nadzoru człowieka.
Od momentu przekazania do supportu pełnego pakietu dowodowego minęło siedem dni. Nie chodziło przy tym o krótką wiadomość w stylu „coś nie działa”, ale o przygotowany materiał zawierający opis problemu, środowiska, przebiegu sesji, logi, zrzuty ekranu i PDF porządkujący dowody. Innymi słowy, po stronie użytkownika wykonano już znaczną część pracy diagnostycznej, która miała ułatwić zespołowi technicznemu odtworzenie i ocenę problemu.
Mimo tego przez cały ten czas nie otrzymałem żadnej merytorycznej odpowiedzi odnoszącej się do przedstawionych dowodów. Jedyną informacją pozostaje ogólny komunikat na czacie, że sprawa została przekazana do zespołu specjalistów i należy uzbroić się w cierpliwość. Nie otrzymałem numeru zgłoszenia, który pozwalałby jednoznacznie identyfikować sprawę, nie dostałem potwierdzenia przyjęcia materiałów na e-mail ani informacji, kto lub jaki zespół prowadzi dalszą analizę. Nie wiadomo również, czy przesłany pakiet został już technicznie przejrzany, czy nadal oczekuje w kolejce.
Sama potrzeba eskalacji nie jest niczym niezwykłym. Złożone problemy dotyczące modeli, środowiska wykonawczego czy aplikacji desktopowej mogą wymagać udziału inżynierów i nie oczekuję, że tego typu reklamacja zostanie rozstrzygnięta w kilka godzin. Problemem jest raczej brak przejrzystości procesu. Po tygodniu użytkownik nadal nie wie, czy zgłoszenie posiada formalny numer, czy materiał dotarł do właściwego zespołu, jaki jest status analizy ani kiedy można oczekiwać kolejnej informacji.
Ma to szczególne znaczenie w sytuacji, w której przedmiotem reklamacji jest właśnie niewiarygodne raportowanie stanu pracy przez system. Użytkownik zgłasza problem polegający między innymi na tym, że AI potrafiło informować o zakończeniu lub weryfikacji zadania, mimo że faktyczny stan był inny, a następnie trafia do procesu supportowego, w którym również otrzymuje jedynie bardzo ogólny status bez możliwości samodzielnego sprawdzenia, co faktycznie dzieje się ze sprawą.
W praktyce powstaje więc drugi poziom tego samego problemu: brak informacji wystarczającej do oceny rzeczywistego stanu procesu.
Nie twierdzę, że siedem dni samo w sobie dowodzi, iż support nie pracuje nad sprawą. Byłoby to wnioskowanie bez danych, a właśnie tego rodzaju nadmiernej pewności krytykuję w tym artykule. Mogę natomiast stwierdzić coś znacznie prostszego: przez siedem dni od przekazania obszernej dokumentacji nie otrzymałem żadnej merytorycznej odpowiedzi, numeru sprawy ani wiadomości e-mail potwierdzającej dalszy tok postępowania.
W przypadku użytkownika płatnego planu Pro taki sposób obsługi trudno pogodzić z oczekiwaniem bardziej przewidywalnego i profesjonalnego procesu wsparcia. Im droższy i bardziej zaawansowany staje się produkt, tym większe znaczenie ma nie tylko dostęp do mocniejszych modeli, ale również jakość procedury wtedy, gdy coś rzeczywiście nie działa.
Bo produkt premium poznaje się nie tylko po tym, co potrafi, gdy wszystko działa prawidłowo.
Równie ważne jest to, jak wygląda obsługa użytkownika wtedy, gdy system zawiedzie.
6000 słów można streścić jednym pytaniem
Po wszystkich błędach CSV, błędach analizy, zatrzymywaniu procesów, źle napisanych skryptach, powtórzonych tekstach, niewłaściwych zdjęciach, problemach z mapowaniem i kolejnych audytach najważniejszy wniosek jest prosty.
Nie pytam już AI wyłącznie: „czy potrafisz to zrobić?”
Coraz częściej pytam: „skąd będę wiedział, że naprawdę to zrobiłeś?”
Bo pierwsze pytanie dotyczy możliwości modelu.
Drugie dotyczy jego użyteczności w prawdziwym biznesie.
ChatGPT Pro potrafi rzeczy imponujące.
Potrafi w kilka minut przeanalizować kod, który człowiek przeglądałby godzinę. Potrafi tworzyć narzędzia, przetwarzać dokumenty i pomagać w projektach wymagających wiedzy z kilku różnych dziedzin.
Ale jeżeli system wykonuje wieloetapową pracę operacyjną, sama inteligencja to za mało.
Potrzebna jest jeszcze konsekwencja.
Potrzebna jest przewidywalność.
Potrzebna jest poprawna obsługa błędów.
Potrzebna jest świadomość zakresu własnej kontroli.
A przede wszystkim potrzebna jest uczciwa informacja: co zostało sprawdzone; co nie zostało sprawdzone; co jest tylko przypuszczeniem; a co rzeczywiście zostało potwierdzone.
Nie oczekuję od ChatGPT perfekcji.
Oczekuję czegoś znacznie prostszego.
Jeżeli nie sprawdził, niech nie mówi, że sprawdził.
Jeżeli analiza się przerwała, niech nie przedstawia częściowego wyniku jako finalnego.
Jeżeli API zakończyło operację, niech nie zakłada, że efekt końcowy jest poprawny.
Jeżeli nie zna wartości, niech jej nie wpisuje na stałe tylko po to, żeby raport wyglądał kompletnie.
Jeżeli nie pamięta wcześniejszej reguły, niech zatrzyma się przed zmianą danych, zamiast tworzyć rezultat sprzeczny z ustaleniami.
I jeżeli status brzmi „FINAL_READY”, powinien naprawdę oznaczać: finalnie gotowe.
Bo właśnie za taką różnicę użytkownicy profesjonalni są gotowi płacić więcej.
Nie za kolejną efektowną odpowiedź.
Za narzędzie, któremu można powierzyć pracę i rozsądnie ufać, że poinformuje nas zgodnie z prawdą, kiedy ta praca została rzeczywiście zakończona.
Mój werdykt po tej pracy
Czy polecam ChatGPT Pro do samodzielnej pracy operacyjnej bez nadzoru człowieka? Nie. Po doświadczeniach opisanych w tym artykule nie powierzyłbym mu bez kontroli procesu, w którym wynik ma być bezpośrednio publikowany, zapisywany w systemie produkcyjnym albo przekazywany klientowi jako zweryfikowany. Nie dlatego, że ChatGPT jest bezużyteczny: przeciwnie, jako narzędzie wspierające analizę, programowanie, research czy przygotowywanie pierwszych wersji materiałów potrafi być bardzo wartościowy. Problem zaczyna się wtedy, gdy ma samodzielnie wykonać długi proces, skontrolować własny rezultat i jeszcze zdecydować, że praca jest zakończona. W moim przypadku właśnie na tym etapie pojawiały się błędy, fałszywe statusy gotowości, utrata kontekstu i konieczność ręcznej kontroli tego, co system wcześniej sam oznaczył jako sprawdzone. Dlatego polecam ChatGPT Pro jako bardzo mocnego asystenta, ale nie jako autonomicznego wykonawcę, któremu można bez weryfikacji powierzyć odpowiedzialną pracę operacyjną.
Najczęstsze pytania
Czy ChatGPT Pro może popełniać błędy podczas analizy danych?
Tak. Nawet przy stosunkowo prostych plikach i jasno określonych regułach mogą wystąpić błędy analizy, przerwane wykonania lub nieprawidłowa interpretacja wyniku.
Czy status „zweryfikowane” oznacza, że wynik został sprawdzony w całości?
Nie zawsze. W opisanym przypadku system potrafił potwierdzić część warunków, a następnie przedstawić rezultat jako w pełni zweryfikowany, mimo że pozostały błędy.
Czy warto używać ChatGPT Pro do pracy biznesowej?
Tak, ale przy zadaniach operacyjnych warto stosować niezależną kontrolę, szczególnie gdy wynik wpływa na dane klientów, publikacje, oferty lub systemy produkcyjne.
Źródła
- About ChatGPT Pro tiers · OpenAI Help Center
- What is Data Analysis in ChatGPT? · OpenAI Help Center